Mape
U ovoj lekciji upoznaćemo strukturu podataka koja efikasno povezuje jednu vrednost sa drugom - mape (en. map), poznate i kao rečnici (en. dictionary) ili heap-ovi (en. heap).
Zamisli da nam je dato n brojeva i da treba da prebrojimo koliko se puta svaki od njih pojavljuje.
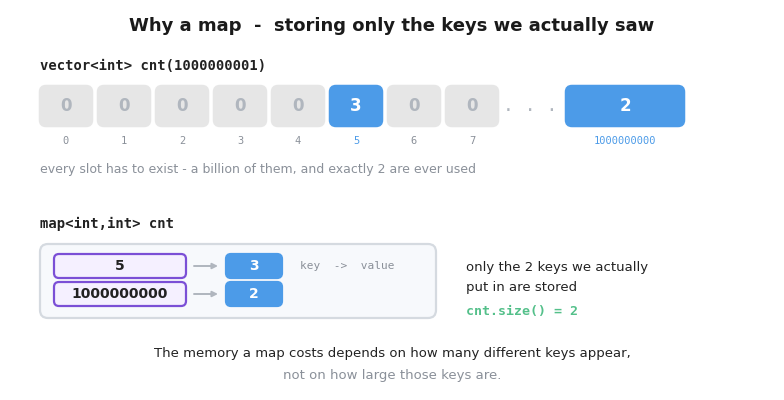
Za male brojeve već znamo trik iz Sortiranja Prebrojavanjem: napravimo niz cnt i radimo cnt[x]++. Ali šta ako brojevi idu do ? Niz od milijardu elemenata ne staje u memoriju - iako bismo iskoristili najviše n njegovih mesta.
Treba nam nešto što pamti samo one ključeve koje smo zaista videli. Upravo to radi mapa.
Parovi
Pre same mape, treba nam jedan mali alat: par (en. pair). pair spaja dve vrednosti u jedan objekat:
Primer:
int main(){

    pair<string, int> p = {"Ana", 17};

    cout<<p.first<<'\n';  //prva vrednost
    cout<<p.second<<'\n'; //druga vrednost

    p.second = 18; //možemo da ih menjamo

    cout<<p.second;

    return 0;
}
Output:
Ana
17
18
Dve vrednosti ne moraju biti istog tipa, a do njih dolazimo preko .first i .second. Parovi mogu da se čuvaju u vektorima, porede i sortiraju (prvo po .first, pa tek onda po .second) - ali nama sada trebaju iz jednog razloga: mapa je sagrađena od parova.
Šta je mapa?
Mapa čuva parove ključ - vrednost. Ključ je ono po čemu tražimo, a vrednost je ono što dobijamo nazad.
Zamisli pravi rečnik: reč je ključ, a definicija je vrednost.
Najvažnije je to što ključ može da bude skoro bilo šta - broj koliko god veliki, string, čak i par. Mapa ne rezerviše mesto za svaki mogući ključ, već pamti samo one koje smo stvarno ubacili.
Inicijalizacija: map<tip_ključa, tip_vrednosti> m, na primer map<string, int> godine.
Funkcije
| Funkcija | Šta radi | Složenost |
|---|---|---|
m[k] |
vrednost zapamćena pod ključem k |
O(log n) |
m[k] = v |
upisuje vrednost v pod ključ k |
O(log n) |
count(k) |
vraća 1 ako ključ k postoji, 0 ako ne postoji |
O(log n) |
erase(k) |
briše ključ k zajedno sa njegovom vrednošću |
O(log n) |
size() |
broj ključeva u mapi | O(1) |
empty() |
vraća true ako je mapa prazna |
O(1) |
clear() |
briše sve | O(n) |
Ovde je n broj ključeva koji se trenutno nalaze u mapi. Primeti da ništa više nije O(1) - taj logaritam je cena koju plaćamo za to što ključ može da bude bilo šta.
Primer:
int main(){

    map<string, int> godine;

    godine["Ana"] = 17;
    godine["Marko"] = 20;

    godine["Ana"]++; //Ana je imala rođendan

    cout<<godine["Ana"]<<'\n';
    cout<<godine.size()<<'\n';
    cout<<godine.count("Marko")<<'\n';
    cout<<godine.count("Jovan");

    return 0;
}
Output:
18
2
1
0
Zamka podrazumevane vrednosti
Primeti da smo napisali godine["Ana"]++, a da nikada nismo postavili godine["Ana"] na 0. To radi zato što ključ koji nikada nije korišćen kreće od podrazumevane vrednosti svog tipa - 0 za brojeve, prazan string za stringove.
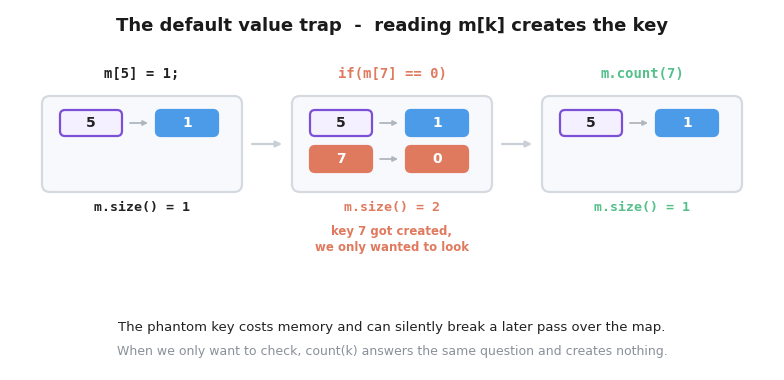
Vrlo zgodno, ali krije zamku: već i samo čitanje m[k] pravi ključ.
Primer:
int main(){

    map<int, int> m;

    m[5] = 1;

    cout<<m.size()<<'\n';

    if(m[7] == 0){ //samo smo hteli da proverimo!
        cout<<"7 nije ovde"<<'\n';
    }

    cout<<m.size(); //ali se 7 ipak napravilo

    return 0;
}
Output:
1
7 nije ovde
2
Taj višak ključeva nije samo neurednost - troši memoriju i može tiho da pokvari petlju koja kasnije prolazi kroz mapu. Kada želimo samo da proverimo da li ključ postoji, koristimo count(k), koji nikada ništa ne pravi.
Prebrojavanje pojavljivanja
Sa svim ovim, problem sa početka lekcije svodi se na tri linije:
Primer:
int main(){

    vector<int> a = {1000000000, 5, 5, 1000000000, 5};

    map<int, int> cnt;

    for(int i=0;i<a.size();i++){
        cnt[a[i]]++;
    }

    cout<<cnt[5]<<'\n';
    cout<<cnt[1000000000];

    return 0;
}
Output:
3
2
Mapa drži tačno 2 ključa, koliko god sami brojevi bili veliki. Memorija zavisi od toga koliko različitih vrednosti se pojavljuje, a ne od toga koliko su te vrednosti velike.
Prolazak kroz mapu
Mapa u svakom trenutku drži ključeve sortirano. Kada prolazimo kroz nju, dobijamo ključeve u rastućem redosledu, a svaki korak nam daje po jedan par:
Primer:
int main(){

    map<string, int> cnt;

    cnt["banana"] = 2;
    cnt["jabuka"] = 5;
    cnt["višnja"] = 1;

    for(auto p : cnt){
        cout<<p.first<<" -> "<<p.second<<'\n';
    }

    return 0;
}
Output:
banana -> 2
jabuka -> 5
višnja -> 1
auto govori kompajleru da sam zaključi tip - ovde je p par stringa i inta. Obrati pažnju i na to da je p kopija para, pa njegova izmena ne menja ništa u mapi. Ako želimo da menjamo vrednosti dok prolazimo, pišemo for(auto &p : cnt).
unordered_map
Držanje svega sortiranim nije besplatno. Kada nam redosled nije bitan, unordered_map radi isti posao pomoću heš tabele:
map |
unordered_map |
|
|---|---|---|
| Redosled ključeva | sortiran | proizvoljan |
| Pretraga, upis, brisanje | O(log n) | O(1) u proseku |
| Ključevi koje prima | sve što se poredi sa < |
sve što se može heširati (parovi ne rade odmah) |
Način korišćenja je isti, menjamo samo ime: unordered_map<string, int> godine.
Znači unordered_map je uglavnom brža varijanta. Caka je u tome što je O(1) samo prosek. U najgorem slučaju, kada mnogo ključeva završi u istoj pregradi, spada čak na O(n) po operaciji. Na sajtovima gde testove zadaju drugi takmičari (npr. codeforces "hacks"), ovo je poznat način da se rešenja obore - neko namerno napravi ulaz u kome se ključevi sudaraju.
Napomena:
Uzmimapkada ti treba redosled ključeva ili kada su ključevi parovi. Uzmiunordered_mapkada ti treba samo brzina i kada niko ne piše testove protiv tebe. Kada nisi siguran, O(log n) koje dajemapje sigurniji izbor.