Skupovi (Set)
U ovoj lekciji upoznaćemo strukturu vrlo blisku mapi, ali jednostavniju - Skup (en. set)!
Ponekad nam uz ključ ne treba nikakva vrednost. Zanima nas samo koji se elementi uopšte pojavljuju: da li sam već video ovaj broj, koliko različitih reči ima u tekstu i slično.
Za to služi skup - struktura koja čuva elemente, drži ih sortirano i ne dozvoljava ponavljanja.
Ako dodamo element koji već postoji, ništa se neće desiti. Zato nikada ne moramo ručno da proveravamo da li se nešto ponavlja, skup to radi umesto nas.
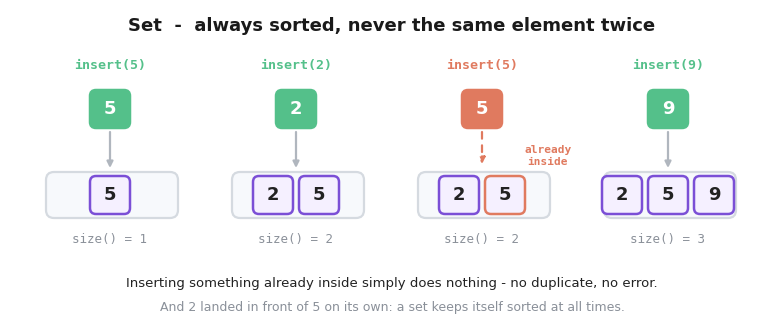
Inicijalizacija: set<int> s
Funkcije
| Funkcija | Šta radi | Složenost |
|---|---|---|
insert(x) |
dodaje x (ako x već postoji, ništa se ne dešava) |
O(log n) |
erase(x) |
briše x (ako x ne postoji, ništa se ne dešava) |
O(log n) |
count(x) |
vraća 1 ako x postoji u skupu, inače 0 |
O(log n) |
find(x) |
vraća pokazivač na x, ili s.end() ako x ne postoji |
O(log n) |
size() |
broj elemenata | O(1) |
empty() |
vraća true ako je skup prazan |
O(1) |
clear() |
briše sve | O(n) |
Primeti da nema s[i]. Skup nije niz i ne možemo da tražimo treći po redu element. On odgovara samo na pitanje da li se nešto nalazi u njemu, a elemente nam vraća u sortiranom redosledu.
Primer:
int main(){

    set<int> s;

    s.insert(5);
    s.insert(2);
    s.insert(5); //već postoji, ništa se ne dešava
    s.insert(9);

    cout<<s.size()<<'\n';
    cout<<s.count(2)<<'\n';
    cout<<s.count(7)<<'\n';

    s.erase(2);

    cout<<s.size();

    return 0;
}
Output:
3
1
0
2
Prolazak kroz skup
Kao i kod mape, prolaskom kroz skup dobijamo elemente u rastućem redosledu:
Primer:
int main(){

    vector<string> reci = {"cp", "learn", "cp", "to", "learn"};

    set<string> razlicite;

    for(int i=0;i<reci.size();i++){
        razlicite.insert(reci[i]);
    }

    cout<<razlicite.size()<<'\n';

    for(auto r : razlicite){
        cout<<r<<'\n';
    }

    return 0;
}
Output:
3
cp
to
learn
Sa svega nekoliko linija dobili smo i broj različitih reči i njihov sortiran spisak. Bez skupa bismo morali prvo da sortiramo niz, pa da ručno prolazimo kroz njega i izbacujemo ponavljanja.
Najmanji i najveći element
Pošto je skup uvek sortiran, na početku mu se nalazi najmanji, a na kraju najveći element. Do oba dolazimo odmah:
Primer:
int main(){

    set<int> s = {7, 2, 9, 4};

    cout<<*s.begin()<<'\n';  //najmanji
    cout<<*s.rbegin()<<'\n'; //najveći

    s.erase(s.begin()); //brišemo najmanji

    cout<<*s.begin();

    return 0;
}
Output:
2
9
4
begin() pokazuje na prvi (najmanji), a rbegin() na poslednji (najveći) element. Reč je o pokazivačima, o kojima ćemo detaljnije kasnije - za sada nam je dovoljno da * ispred pokazivača znači vrednost na koju on pokazuje. Obe operacije su O(1), pa nam skup u svakom trenutku daje i trenutni minimum i trenutni maksimum.
find
count(x) nam govori samo da li se element nalazi u skupu. Često nam treba i gde se nalazi, a to radi find(x) - vraća pokazivač na traženi element, ili s.end() ako elementa nema.
s.end() označava mesto iza poslednjeg elementa. To nije element i ne smemo ga čitati preko *, jer bi program pukao. Zato rezultat funkcije find uvek prvo uporedimo sa s.end().
Primer:
int main(){

    set<int> s = {10, 20, 30};

    if(s.find(20) != s.end()){
        cout<<"20 postoji"<<'\n';
    }

    if(s.find(25) == s.end()){
        cout<<"25 ne postoji"<<'\n';
    }

    auto it = s.find(30);

    cout<<*it<<'\n';

    s.erase(it); //brišemo preko pokazivača

    cout<<s.size();

    return 0;
}
Output:
20 postoji
25 ne postoji
30
2
Ako nam count već govori da li je element unutra, zašto onda uopšte koristimo find? Zbog dve stvari:
- Brisanje.
s.erase(it)briše tačno onaj element na koji pokazivač pokazuje, bez ponovnog traženja. Ako napišemoif(s.count(x)) s.erase(x);, skup pretražujemo dva puta, a prekofind-a samo jednom. - Susedi. Kada imamo pokazivač na neki element,
it++nas vodi na sledeći veći, ait--na prethodni manji element. Tako od skupa možemo da tražimo i ono što se nalazi odmah pored zadate vrednosti, a to nam u zadacima treba vrlo često.
Napomena:
Pazi na krajeve:it++sa poslednjeg elementa vodi nas.end(), ait--sas.begin()je nedefinisano ponašanje. Pre pomeranja proveriit != s.begin()iit != s.end().
Pretraga unutar skupa
Skup je sortiran, pa u njemu možemo da radimo binarnu pretragu. Ali pazi: lower_bound(a.begin(), a.end(), x), koji smo naučili za vektore, nad skupom radi u O(n), jer skup ne može da skoči na svoj srednji element kao što niz može. Zato skup ima sopstvenu verziju, s.lower_bound(x), koja radi u O(log n) - nju uvek koristimo.
Primer:
int main(){

    set<int> s = {10, 20, 30, 40};

    cout<<*s.lower_bound(25)<<'\n'; //prvi element >= 25
    cout<<*s.upper_bound(30)<<'\n'; //prvi element > 30

    if(s.lower_bound(100) == s.end()){
        cout<<"nema nista >= 100";
    }

    return 0;
}
Output:
30
40
nema nista >= 100
I ove funkcije vraćaju pokazivač, kao i find, a ako traženog elementa nema, opet dobijamo s.end(). Pravilo je isto: kada odgovor možda ne postoji, prvo ga uporedi sa s.end().
unordered_set i multiset
Kao i kod mape, postoje još dve varijante skupa:
set |
unordered_set |
multiset |
|
|---|---|---|---|
| Redosled | sortiran | proizvoljan | sortiran |
| Ponavljanja | ne čuva ih | ne čuva ih | čuva ih |
| Operacije | O(log n) | O(1) u proseku | O(log n) |
lower_bound |
da | ne | da |
unordered_set menja redosled za brzinu, baš kao unordered_map, i ima istu slabu tačku - namerno napravljen ulaz može da ga obori na O(n) po operaciji.
multiset radi suprotno i čuva ponavljanja, što nam treba kada nam je potrebna sortirana kolekcija u kojoj ista vrednost sme da se pojavi više puta.
Napomena:
Pazi kodmultiset-a:s.erase(x)briše sve kopije vrednostixodjednom. Ako želimo da obrišemo samo jednu, pišemos.erase(s.find(x)), ali samo kada smo sigurni daxzaista postoji.
Napomena:
Skup je u suštini mapa bez vrednosti. Sve što radiset<int>može imap<int, bool>, samo je sa skupom kod kraći i jasniji. Čim ti zatreba da uz svaki element vežeš još neki podatak, prelaziš na mapu.